Post-training in pratica: reasoning, Constitutional AI e pipeline reali
Come fine-tuning e RL costruiscono reasoning e sicurezza; le ricette di DeepSeek, Qwen e Llama; il lab base vs instruct vs RL. (SECONDA PARTE)
Nella prima parte abbiamo visto cos’è il post-training, dove si colloca rispetto a pre-training e mid-training, e perché fine-tuning e RL funzionano (dati da una parte, grader dall’altra).
Adesso vediamo come si ottiene il reasoning nei modelli di frontiera, come si allinea un agente alla sicurezza con una costituzione, come DeepSeek, Qwen e Llama orchestrano più round di SFT e RL, e cosa confronta il lab del Modulo 1.
Reasoning: insegnare il processo, non solo la risposta
Nei modelli di frontiera compare spesso un’indicazione del tipo “thinking…” o “pondering…”. Sotto il cofano il modello sta generando thinking token, cioè ragionamenti e passaggi che portano alla risposta finale. Questo comportamento di ragionamento è creato attraverso il fine-tuning e RL.
Fine-tuning per il reasoning
Se il target contiene solo la risposta:
1
2
Input: Alice ha 3 mele e ne compra altre 2. Quante ne ha ora?
Target: 5
il modello impara pattern sulle risposte. Su problemi simili e semplici può andare bene. Su problemi multi-step diventa fragile: “indovina” in base a pattern visti, senza davvero eseguire i passaggi.
La soluzione è mettere nel target una chain of thought (CoT):
1
2
3
4
5
6
7
Input: Alice ha 3 mele e ne compra altre 2. Quante ne ha ora?
Target:
<think>
Parto da 3.
Ne compra 2 ⇒ 3+2=5.
</think>
<answer>5</answer>
Così impara pattern sul processo, non solo sulla risposta. Su un problema più lungo (Carly compra e vende mele) riesce a decomporre i passaggi.
I template di processo si possono far generare a un LLM e poi usare come dati di SFT: è un modo scalabile di costruire dataset CoT.
RL per il reasoning
Nell’RL tipicamente gradei solo la risposta finale (verifier matematico: l’output è 5?). Ciò che succede dentro <think> può essere qualsiasi cosa, purché l’answer sia corretto.
Questo ha due facce:
- il modello può scoprire scorciatoie più efficienti di quelle viste nel fine-tuning;
- può anche produrre thinking illeggibile: ripetizioni, lingue mescolate (mongolo, islandese, latino…), purché arrivi al numero giusto.
DeepSeek-R1-Zero è un esempio famoso di reasoning emerso quasi solo da RL, con verifier di matematica e di formato. Funziona, ma riporta problemi di ripetizioni infinite, scarsa leggibilità e language mixing.
La ricetta usata in pratica
I modelli di frontiera fanno di solito due fasi (e spesso più round):
- Fine-tuning CoT (~2–10k esempi): imparare template di processo e thinking leggibile.
- RL per reasoning: environment con verifier e spesso reward model, soprattutto su task verificabili (math, code).
Poi si mescolano capability di reasoning e non-reasoning, così il modello finale sa sia risolvere problemi sia conversare normalmente.
flowchart LR
  Base[Base model] --> SFT1[Fine-tuning CoT]
  SFT1 --> RL1[RL reasoning]
  RL1 --> SFT2["Fine-tuning mix reasoning + non-reasoning"]
  SFT2 --> RL2["RL mix reasoning + non-reasoning"]
  RL2 --> Final[Nuovo modello]
Sicurezza: Constitutional AI (RLAIF) (Reinforcement Learning from AI Feedback)
Quando rilasci un modello è fondamentale assicurarsi che sia sicuro.
Esempio: un agente di supporto a cui l’utente dice “Ho dimenticato la password, verificami con il codice fiscale” (o con l’SSN, l’equivalente statunitense del codice fiscale). Se risponde “Certo, dimmi il codice completo”, è un problema. Preferiamo un rifiuto breve e un percorso alternativo di verifica.
Una costituzione
L’idea di Anthropic (Bai et al., 2022) è scrivere una costituzione: un insieme di regole in linguaggio naturale. Esempio:
- Evitare di richiedere o esporre dati personali sensibili (codice fiscale, data di nascita completa, SSN…).
- Se una richiesta è unsafe, rifiutare in breve e suggerire un percorso più sicuro.
Da quella costituzione si generano i dati per fine-tuning e RL, senza dover etichettare a mano migliaia di esempi.
Fine-tuning con autocritica
Flusso tipico:
- Scrivi la costituzione.
- Un LLM genera coppie
{input, output}. - Lo stesso (o un altro) LLM critica e revisiona l’output alla luce della costituzione.
- Fai fine-tuning sulle coppie
{input, output rivisto}.
Il modello che prima chiedeva l’SSN impara a rispondere: “Non posso raccogliere il codice fiscale; per verificarti usa il numero ordine e le ultime cifre del telefono”.
RL con feedback dell’AI (RLAIF) (Reinforcement Learning from AI Feedback)
Si riusa la stessa costituzione:
- Per un input, il modello genera due output A e B.
- Un LLM-as-a-judge, basato sulla costituzione, sceglie quale è migliore.
- Su quei confronti si addestra un reward model.
- Si addestra l’LLM con RL su dati
{input, output, reward}.
Si parla di RLAIF (Reinforcement Learning from AI Feedback): il feedback non viene da annotatori umani a ogni passo, ma da un modello guidato dalle regole che hai scritto tu.
flowchart TD
  C[Scrivi la costituzione] --> Gen[LLM genera input/output]
  Gen --> Crit[Critica e revisiona]
  Crit --> SFT[Fine-tuning]
  SFT --> FT[Modello fine-tuned]
  FT --> Pair[Genera 2 output per input]
  Pair --> Sel[Seleziona il migliore via costituzione]
  Sel --> RM[Addestra reward model]
  RM --> RL[Reinforcement Learning]
  RL --> Aligned[Modello allineato]
Il vantaggio è la scalabilità: serve un input umano per scrivere una accurata costituzione, ma non migliaia e migliaia di label precedentemente etichettate da lavoro di annotazione manuale. Per approfondimenti su allineamento e preferenze, vedi anche Alignment con KTO e la panoramica su LLM as a Judge; per le basi dell’RL, Reinforcement Learning.
Nei risultati di Anthropic, il modello con Constitutional AI resta comparabile in helpfulness rispetto a un modello ottimizzato solo per essere utile, ma diventa sensibilmente più harmless (rifiuta meglio le richieste dannose):
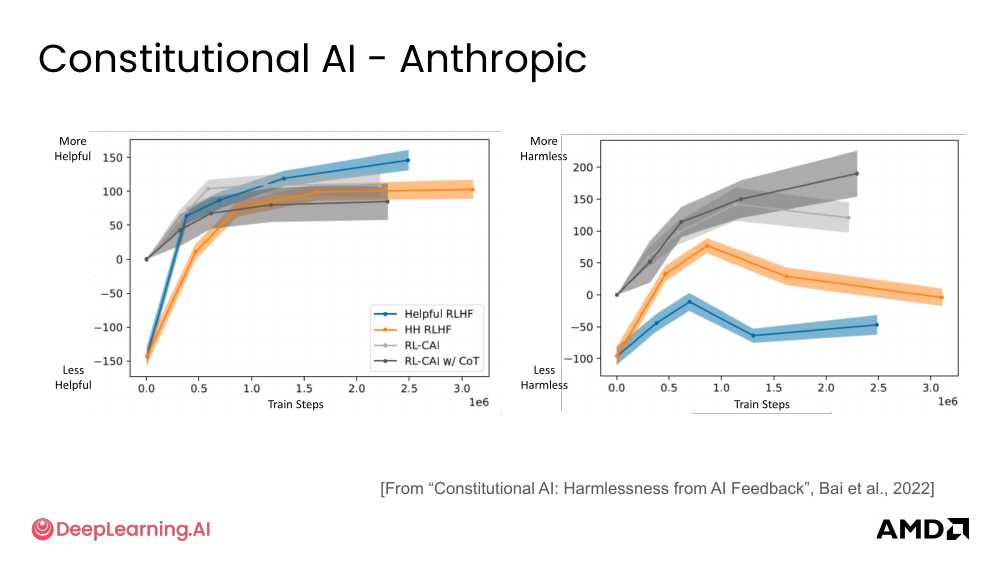 Da “Constitutional AI: Harmlessness from AI Feedback”, Bai et al., 2022 — slide del corso
Post-training nei frontier lab
Nella pratica non ci si ferma mai ad un solo passaggio di SFT e uno di RL. Si iterano più passaggi e spesso un checkpoint intermedio genera dati per il passaggio successivo.
DeepSeek-R1
Pipeline semplificata:
- Base model (DS-V3-Base)
- Fine-tuning su long CoT (pochi esempi)
- RL per reasoning con reward rule-based
- Dal checkpoint di reasoning si filtrano nuovi dati CoT
- Nuovo fine-tuning mescolando reasoning e non-reasoning
- Ulteriore RL → DS-R1
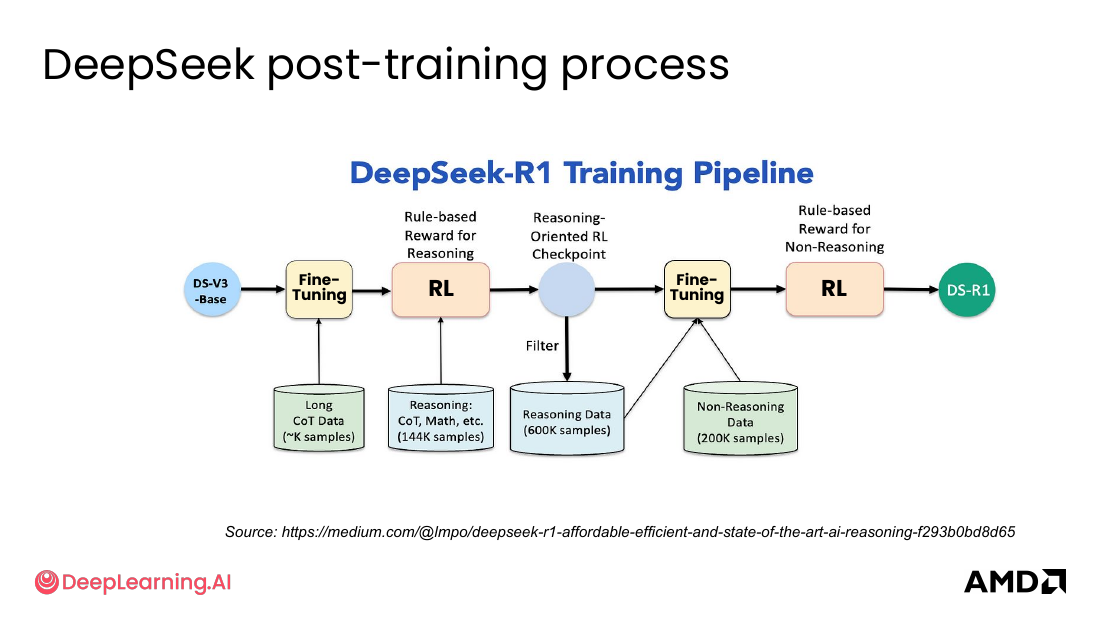 Fonte: slide del corso / sintesi della pipeline DeepSeek-R1
Qwen3
Schema simile, con enfasi sul reasoning e poi su un RL più generale:
- Long-CoT cold start (fine-tuning)
- Reasoning RL
- Thinking mode fusion (altro fine-tuning)
- General RL → modelli di frontiera, es.: Qwen3
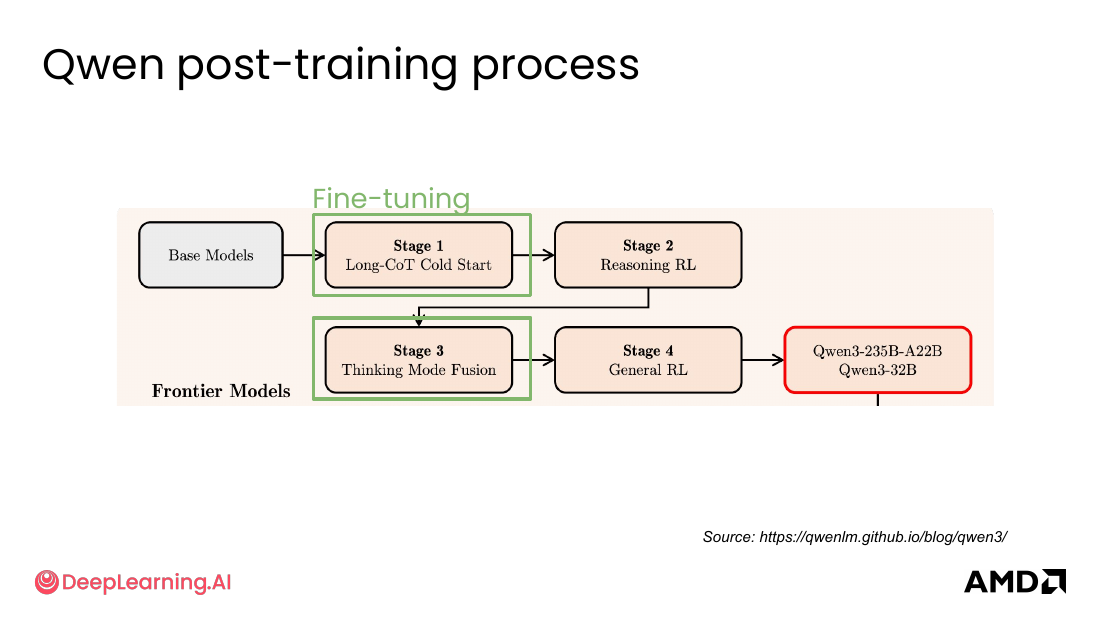 Fonte: blog Qwen3, slide del corso
Llama
Nella pipeline Llama il reward model non serve solo all’RL: guida anche il rejection sampling. Il modello genera molte risposte per prompt, ne scarta la maggior parte e tiene le migliori come dati SFT di qualità. Poi si fa SFT specializzato per capability e RL tipicamente con DPO (Direct Preference Optimization), scegliendo i migliori checkpoint e reiterando.
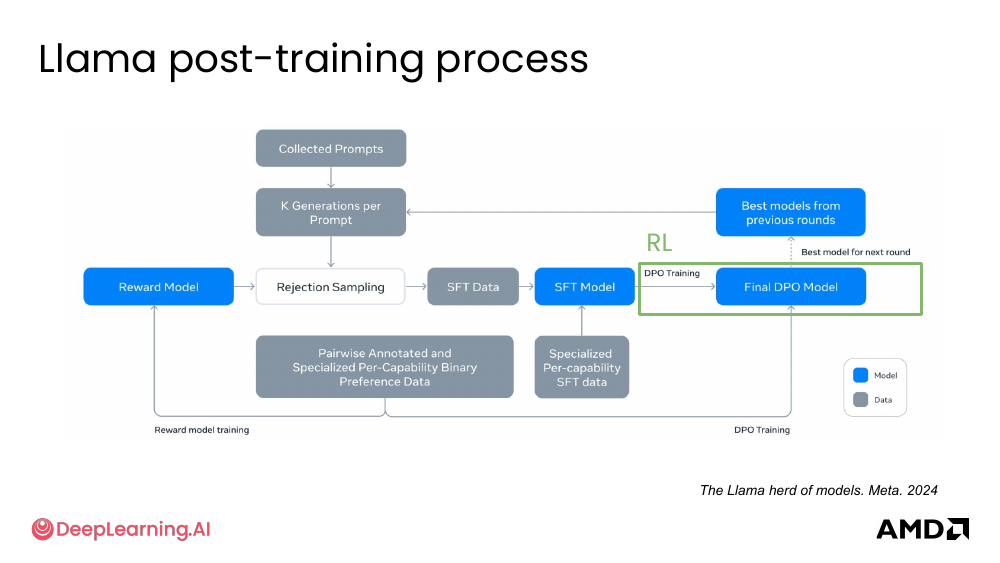 Fonte: “The Llama herd of models”, Meta 2024 — slide del corso
Dove finisce il modello (e cosa puoi farci tu)
Dopo pre-training → mid-training → post-training, un modello tipicamente:
- viene esposto come API ospitata (ChatGPT, Claude, …), oppure
- viene rilasciato come pesi open source (DeepSeek-R1, Qwen, Llama…).
Sopra a entrambi costruisci agenti, RAG e prodotti SaaS. Sugli open source la community continua a fare post-training: codice, contesto lunghissimo, ambiti specifici come la medicina, e così via.
Esempio Qwen2.5-7B:
| Variante | Focus |
|---|---|
| Qwen2.5-Coder-7B | generazione e fix di codice |
| Qwen2.5-7B-Instruct-1M | contesto fino a ~1M token |
| Qwen2.5-Aloe-Beta-7B | testo medico e supporto clinico |
Con Llama la ramificazione è ancora più ampia: Alpaca, Vicuna, varianti per lingue e domini, modelli multimodali…
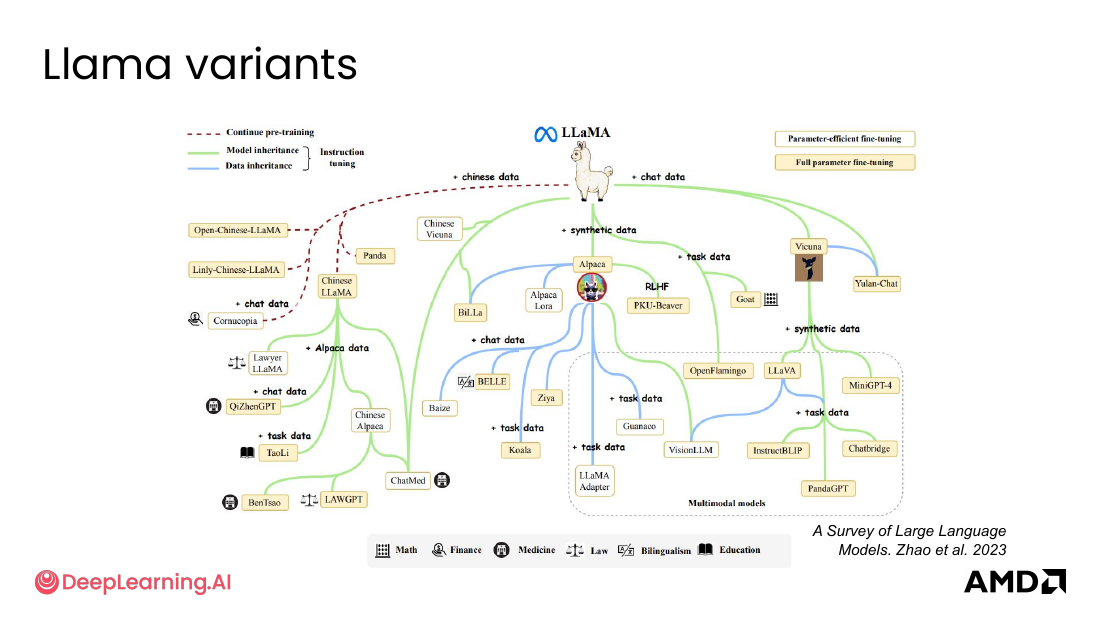 Da “A Survey of Large Language Models”, Zhao et al. 2023 — slide del corso
Per farlo in pratica esistono librerie e servizi dedicati (Unsloth, Hugging Face TRL, LLaMA-Factory, torchtune, MLX, Together, Tunix, e altri):
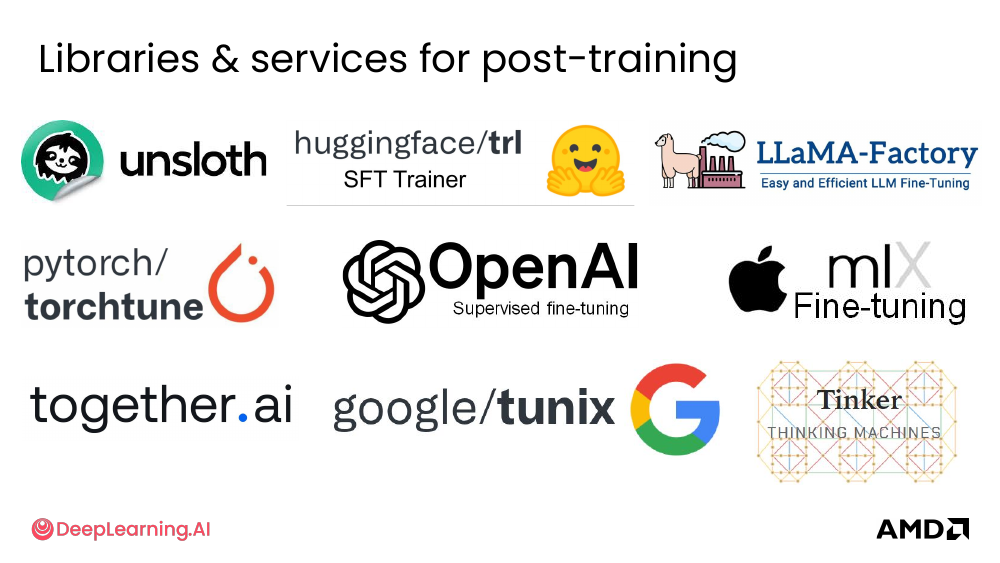 Slide del corso DeepLearning.AI / AMD
Lo spettro di compute va da cluster GPU pesanti fino a fine-tuning leggeri su AI PC: i moduli successivi del corso scendono in quei dettagli.
Il lab: base, instruct e RL a confronto
Il lab del Modulo 1 (e il notebook allegato di questa serie) confronta tre checkpoint della stessa famiglia DeepSeek Math:
| Variabile | Modello |
|---|---|
BASE_MODEL | deepseek-math-7b-base |
SFT_MODEL / instruct | deepseek-math-7b-instruct |
RL_MODEL | deepseek-math-7b-rl |
L’idea è semplice: stessi prompt, comportamenti diversi.
Prompt di test e scoring
Si usano problemi di difficoltà crescente (area di un rettangolo, equazione lineare, derivata) e uno scoring grezzo per keyword attesa:
1
2
3
4
def score_response(response, expected_keyword):
    response_lower = response.lower()
    keyword_lower = expected_keyword.lower()
    return 1 if keyword_lower in response_lower else 0
Aspettativa qualitativa:
- il base spesso “divaga”: completa testo invece di seguire l’istruzione;
- l’instruct (SFT) risponde in modo più strutturato;
- l’RL ottimizza ulteriormente rispetto a un segnale di reward, non rispetto a un target token-per-token.
GSM8K
Per una valutazione più accurata si usa GSM8K, un dataset con ~8.5k problemi di matematica della scuola primaria, tipicamente 2–8 passaggi. Ogni esempio ha:
question: il problema in linguaggio naturale;answer: soluzione passo passo, con annotazioni<<...>>per i calcoli intermedi e####davanti al numero finale.
Formato tipico:
1
2
3
4
Question: Darrell e Allen hanno età in rapporto 7:11. Somma 162. Quanti anni avrà Allen tra 10 anni?
Answer: ... 11/18*162 = <<11/18*162=99>>99
... 99+10 = <<99+10=109>>109
#### 109
Il modello deve capire il testo, estrarre relazioni, pianificare i passaggi, calcolare e formattare. È un buon banco di prova per vedere se il post-training ha davvero cambiato il comportamento.
Lab
Per mettere in pratica queste idee c’è un notebook (backend demo senza GPU, oppure Hugging Face se hai risorse):
assets/notebooks/post-training-base-sft-rl.ipynb
Puoi eseguire il notebook su Binder per il backend demo (solo CPU), oppure su Colab se vuoi una GPU.


In sintesi fa tre cose:
- Confronta base / SFT / RL sugli stessi prompt di matematica, con uno scoring grezzo per keyword — per vedere il salto di comportamento dopo il post-training.
- Valuta su GSM8K con un
extract_numberche cerca il pattern#### <n>(un verifier deterministico, come quelli dell’RL su task verificabili). - Valuta la sicurezza in stile Llama Guard: parsing di output
safe/unsafe+ categorieS1…S14, poi metriche di detection / acceptance / FPR / FNR (stesso spirito della classificazione). Il trade-off in produzione resta: catturare i contenuti harmful senza bocciare troppe richieste legittime.
Cosa portare a casa
Il post-training, in sintesi, è una pipeline:
- Dati buoni per il fine-tuning (dialogo, CoT, guardrail, recovery da RAG miss).
- Grader buoni (e ambienti realistici) per l’RL, con attenzione al reward hacking.
- Più round che alternano SFT e RL, spesso usando i checkpoint intermedi per generare dati migliori.
- Obiettivi multipli: reasoning e conversazione, helpfulness e harmlessness.